Портативная, родная для Git модель для читаемой агентом AI памяти
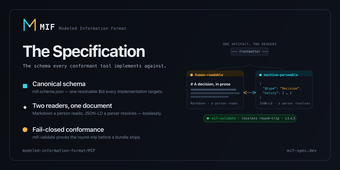
MIF (Моделируемый информационный формат), от Моделируемого информационного формата, предоставляет нейтральную к поставщику модель данных для переносимого обмена знаниями ИИ. Он упаковывает редактируемый человеком Markdown и потребляемый машиной JSON-LD для создания локально-ориентированных, читаемых агентом пакетов знаний для интегрированных помощников MCP и агентских рабочих процессов. Ключевые элементы включают канонический источник Markdown, производные проекции JSON-LD, происхождение W3C PROV, дву-временную действительность и интеграцию сервера MCP. Инженеры ИИ и менеджеры знаний используют его для поддержания нативной памяти ИИ в Git и снижения избыточности токенов.
Какие задачи вы действительно можете решать с помощью MIF?
MIF нацелена на проблему постоянной памяти ИИ, создавая контекстные пакеты, которые могут использовать агенты с высокой точностью. Формат определяет семантические, эпизодические и процедурные типы и поддерживает типизированные отношения для отображения сложных сущностей. Команды используют эти пакеты, чтобы предоставить структурированный контекст помощникам во время разрешения запросов, поддерживать редактируемый человеком источник правды и представлять знания так, чтобы агенты могли запрашивать их программно.
Насколько точны и отслеживаемы машинно-читаемые проекции?
Полученные проекции включают метаданные, согласованные с W3C PROV, и дву-временное отслеживание для документирования происхождения и свежести, что улучшает отслеживаемость для последующей обработки. Точность выходных данных для агентов зависит от качества канонического Markdown, поскольку источником правды являются люди. На практике надежность увеличивается, когда авторы включают поля происхождения и явные временные окна действительности во время написания, поскольку формат полагается на эти сигналы, чтобы предотвратить предоставление устаревшего контекста.
Какие входные данные и шаблоны развертывания требуются?
Рабочий процесс основан на файловой системе и Git, поэтому проекты хранят пакеты знаний в виде текстовых файлов, а не в внешних векторных базах данных. MIF может работать как сервер MCP (mif-mcp) и интегрируется с клиентами, которые поддерживают Протокол Контекста Модели; развертывание подходит для сред Node.js и TypeScript, а также для распространенных интеграций редакторов, таких как VS Code. Дизайн устраняет обязательный уровень базы данных и позволяет командам хранить память внутри репозитория проекта.
Является ли MIF практичным по сравнению с системами памяти на основе баз данных?
MIF подчеркивает нейтральную переносимость поставщиков по сравнению с функциями баз данных, используя простой Markdown в качестве канонического артефакта, что избегает привязки к проприетарным форматам хранения. Его соответствие OKF способствует совместимости с другими инструментами, которые используют ту же транспортную модель. Проекты, которым необходимо быстрое экспериментирование с памятью, ориентированной на локальный доступ, и явным происхождением, могут принять его, не вводя внешнее векторное хранилище, хотя адаптация существующих конвейеров может потребовать сопоставления текущих схем с предвзятым контентным моделем MIF.
MIF подходит инженерным командам, которые придают приоритет портативному, проверяемому контексту ИИ
MIF является практичным вариантом для инженеров ИИ и менеджеров знаний, которым нужна портативная, локально-ориентированная память, которую агенты могут читать. Его основное ограничение заключается в зависимости от кураторских исходных файлов для правильности вывода, поэтому командам следует добавить этапы проверки и валидации авторов в их контентный поток. Рассматриваемый как часть более широкой рабочей процедуры проверки, он подходит для проектов, которые предпочитают родную память репозитория внешним базам данных.